Adobe Speech Enhancer – KI-gesteuerte Studio-Audio für Podcasts
Einführung
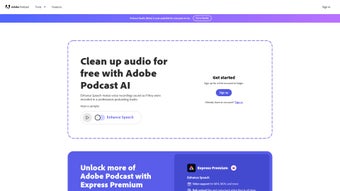
Adobe Speech Enhancer ist eine cloudbasierte, KI-gesteuerte Lösung zur Reinigung von Sprachaufnahmen. Egal ob Sie ein Podcaster sind, der Hintergrundrauschen reduzieren möchte, ein Lehrer, der Vortragsaufnahmen vorbereitet, oder ein Marketer, der klare Sprecherstimmen für Videowerbung benötigt – dieses Tool verspricht Studioqualität ohne den steilen Lernkurve von traditionellen digitalen Audiowerkstätten. Durch die Echtzeit-Analyse jedes Wellenformabschnitts unterdrückt der proprietäre Deep-Learning-Engine automatisch unerwünschtes Rauschen, balanciert die Stimmfrequenzen und normalisiert die Lautstärke auf Rundfunkstandards.
Da die Verarbeitung vollständig im Browser erfolgt, ist keine Installation von schweren Softwarepaketen notwendig, und Benutzer können von jedem Gerät mit einem modernen Browser aus mit der Audioverbesserung beginnen. Das Abonnement beinhaltet kontinuierliche KI-Updates, sodass der Engine stets die neuesten Erkenntnisse in Rauschunterdrückung und Sprachverständlichkeit zur Verfügung stehen. Obwohl der Dienst bei klar aufgenommenen Quellmaterialien besonders brilliert, liefert er auch bei mittelmäßigen Aufnahmen spürbare Verbesserungen und ist somit eine zugängliche Erstbearbeitung für Kreative aller Fähigkeitsstufen.
Sicherheit ist von Haus aus integriert: Dateien werden während des Transfers verschlüsselt, in einer temporären Cloud-Umgebung verarbeitet und automatisch nach 24 Stunden gelöscht – ein Ansatz, der sowohl Datenschutz-Bewusste als auch Unternehmensanforderungen an Compliance erfüllt. Kurz gesagt, Adobe Speech Enhancer schließt die Lücke zwischen rohen, unverarbeiteten Audios und professionell aufbereiteten, hörenswerten Inhalten und spart Kreativen Zeit, Geld und die Frustration manueller Bearbeitung.
Wichtige Funktionen & Vorteile
- KI-Rauschunterdrückung: Fortschrittliche Deep-Learning-Modelle isolieren und unterdrücken Pfeifen, Brummen, Wind und Umgebungsgeräusche, ohne die natürliche Klangfarbe der Sprecherstimme zu beeinträchtigen.
- Dynamische Stimmen-Gleichung: Automatische Frequenzabstimmung erhöht die Klarheit, macht Konsonanten scharf und Vokale weich für ein natürlicheres Hörerlebnis.
- Einfach-Klick-Studio-Modus: Ein einziger Button wendet eine vorgefertigte Kette von Filtern an, die professionelle Studio-Verarbeitung nachahmt – ideal für Nutzer, die sofortige Ergebnisse wollen.
- Echtzeit-Vorschau: Hören Sie sich eine 10-Sekunden-Probe des verbesserten Audios an, bevor Sie die vollständige Exportierung starten, um schnelle Anpassungen vorzunehmen.
- Unterstützung mehrerer Formate: Akzeptiert WAV, MP3, AAC, AIFF und FLAC; die Ausgabe kann das ursprüngliche Format beibehalten oder in ein komprimierteres Format konvertiert werden.
- Batch-Verarbeitung: Laden Sie bis zu 20 Dateien gleichzeitig hoch; der Cloud-Engine verarbeiten jedes File parallel und reduzieren die Bearbeitungszeit für Serieninhalte dramatisch.
- Sichere Cloud-Speicherung: TLS 1.3-Verschlüsselung schützt die Uploads, und Dateien werden innerhalb von 24 Stunden nach der Verarbeitung von Adobes Servern gelöscht.
- Kontinuierliche KI-Updates: Abonnenten erhalten automatisch verbesserte Rauschunterdrückungsmodelle und neue Voreinstellungen ohne zusätzliche Kosten.
- Plattformübergreifende Zugänglichkeit: Funktioniert auf jedem modernen Browser, sodass Windows-, macOS-, Linux-, iOS- und Android-Nutzer Audio verbessern können, ohne zusätzliche Software installieren zu müssen.
- Integrierte Analytics-Dashboard: Nach der Verarbeitung erhalten Benutzer einen detaillierten Bericht mit Angaben zu Rauschunterdrückungsprozenten, Frequenzverschiebungen und Dateigrößenänderungen, was Transparenz und Daten für zukünftige Aufnahmen liefert.
Jede dieser Funktionen zielt darauf ab, einen spezifischen Schmerzpunkt im Audio-Produktionsprozess zu lösen. So entfernt das KI-Rauschunterdrückungs-Modul nicht nur leise Hintergrundgeräusche, sondern unterscheidet auch intelligent zwischen Sprache und Nicht-Sprachelementen, wodurch der „erstickte“ Effekt vermieden wird, den viele generische Filter verursachen. Die Dynamische Stimmen-Gleichung passt sich dem einzigartigen Stimmumfang des Sprechers an und liefert einen ausgewogenen Klang, der sowohl für tiefe Erzähler als auch für hohe Präsentatoren gleichermaßen funktioniert. Die Batch-Verarbeitung ist ein Game-Changer für Podcast-Netzwerke, die mehrere Episoden gleichzeitig veröffentlichen, während das Integrierte Analytics-Tool Kreativen messbare Erkenntnisse liefert, um ihre Aufnahmeprozesse kontinuierlich zu verbessern. Zusammen bilden diese Fähigkeiten eine umfassende, all-in-one-Lösung, die die Notwendigkeit sekundärer Bearbeitungstools reduziert.
Installation, Kompatibilität & Nutzung
Adobe Speech Enhancer ist ein webbasiertes Dienst, daher ist keine klassische Installation erforderlich. Die Anwendung läuft auf jedem Gerät, das einen modernen Browser (Chrome, Edge, Safari, Firefox) und eine stabile Internetverbindung unterstützt. Unterstützte Betriebssysteme sind Windows 10/11, macOS 10.15+, Linux-Distributionen mit aktuellen Browsern, iOS 13+ und Android 9+.
Schritt-für-Schritt-Anleitung
- Adobe-Konto erstellen oder anmelden: Besuchen Sie das Adobe-Portal, registrieren Sie sich mit einer E-Mail-Adresse und wählen Sie das Abonnement-Tarif für Speech Enhancer, das Ihren Nutzungsmustern entspricht (monatlich oder jährlich).
- Zum Speech Enhancer-Dashboard navigieren: Nach der Anmeldung klicken Sie auf das „Speech Enhancer“-Feld. Die Oberfläche zeigt eine saubere Upload-Zone, einen Voreinstellungs-Selector und einen Vorschauspieler.
- Ihre Audio-Datei(en) hochladen: Ziehen Sie bis zu 20 Dateien (max. 500 MB je Datei) per Drag-and-Drop hoch oder verwenden Sie die „Durchsuchen“-Schaltfläche. Das System überprüft Format und Abtastrate, bevor es fortfährt.
- Verarbeitungsmodus wählen: Optionen sind „Standard“ (ausgeglichene Einstellung), „Rundfunk“ (maximale Lautstärke und Rauschunterdrückung) und „Benutzerdefiniert“ (Feinabstimmung von Parametern wie Reduktionsstärke, EQ-Kurve und Lautstärzziel).
- Die verbesserte Ausschnitt-Vorschau anhören: Klicken Sie auf „Vorschau abspielen“, um eine 10-Sekunden-Probe anzuhören. Falls Anpassungen nötig sind, verschieben Sie die Schieberegler im Benutzermodus und prüfen erneut.
- Die Verarbeitungsaufgabe starten: Klicken Sie auf „Verarbeiten & Herunterladen“. Adobe’s Cloud rendernt die Enddatei und fordert Sie auf, sie lokal zu speichern oder in Cloud-Speicher-Dienste wie Dropbox oder Google Drive zu exportieren.
- Den Analysebericht überprüfen: Sobald der Download abgeschlossen ist, erscheint ein Popup mit Angaben zu Rauschunterdrückungsprozenten, Frequenzanpassungen und der endgültigen Dateigröße, sodass Sie vorher-nachher-Metriken vergleichen können.
- Optionale Nachbearbeitung: Für Nutzer, die zusätzliche Feinabstimmung benötigen, kann die heruntergeladene Datei in beliebige DAWs importiert werden, um abschließend Kompression, Mastering oder Hintergrundmusik hinzuzufügen.
Best-Practice-Tipps: Aufnehmen in einer ruhigen Umgebung, Verwendung eines kardioiden Kondensatormikrofons und Beibehaltung einer Abtastrate von 44,1 kHz oder höher. Sauberes Quellmaterial maximiert die Fähigkeit der KI, Sprache von Rauschen zu unterscheiden, und reduziert Artefakte. Vermeiden Sie zudem übermäßige Clipping während der Aufnahme; die KI kann Hintergrundrauschen reduzieren, kann aber stark verzerrte Wellenformen nicht vollständig reparieren. Indem Sie diese Richtlinien befolgen, ziehen Sie die höchstmögliche Qualität aus Adobe Speech Enhancer und reduzieren den Bedarf an weiteren manuellen Bearbeitungen.
Stärken, Schwächen & Häufige Fragen
Stärken
- Sofortige, ein-Klick-Verbesserung mit Studioqualität spart Stunden an manueller Bearbeitung.
- Das KI-Modell wird durch automatische Cloud-Updates kontinuierlich verbessert.
- Keine Software-Installation erforderlich; funktioniert auf jedem modernen Browser über alle Geräte hinweg.
- Sichere, verschlüsselte Verarbeitung mit automatischer Dateilöschung nach 24 Stunden.
- Batch-Verarbeitung beschleunigt den Workflow für Podcasts und Content-Netzwerke.
- Detaillierte Analytics bieten transparente Einblicke in jede Verbesserung.
Schwächen
- Benötigt eine stabile Internetverbindung; Offline-Verarbeitung ist nicht möglich.
- Abonnement-Preise können für gelegentliche Hobbyisten zu hoch sein.
- Kann keine vollwertigen DAWs für Multitrack-Mischung oder fortgeschrittenes Mastering ersetzen.
- Die Leistung hängt von der Qualität der Originalaufnahme ab.
- Große Batch-Jobs können während Spitzenzeiten längere Wartezeiten erfahren.
Häufig gestellte Fragen
Ist Adobe Speech Enhancer als kostenlose Download-Software verfügbar?
Der Dienst ist abonnementbasiert, Adobe bietet jedoch eine 14-tägige kostenlose Testversion mit vollständigem Zugriff auf alle Funktionen. Nach der Testphase müssen Benutzer ein monatliches oder jährliches Abonnement wählen.
Kann ich Adobe Speech Enhancer auf meinem Smartphone oder Tablet nutzen?
Ja. Da der Dienst vollständig im Web-Browser läuft, können Sie ihn auf iOS- und Android-Geräten nutzen, solange der Browser moderne JavaScript- und WebGL-Unterstützung bietet.
Welche Audio-Dateiformate akzeptiert das Tool?
Unterstützte Upload-Formate sind WAV, MP3, AAC, AIFF und FLAC. Das Ausgabeformat entspricht standardmäßig dem Eingabeformat, kann aber vor dem Herunterladen gewählt werden.
Wie schützt Adobe meine hochgeladenen Aufnahmen?
Alle Dateien werden über TLS 1.3-Verschlüsselung übertragen, in einer transienten Cloud-Umgebung verarbeitet und innerhalb von 24 Stunden nach Abschluss endgültig von Adobes Servern gelöscht – dies entspricht den Vorgaben von GDPR und anderen Datenschutzbestimmungen.
Verändert die KI jemals den Ton meiner Stimme?
Die KI ist darauf ausgelegt, die natürliche Klangfarbe zu bewahren. Allerdings können extrem schlechte Aufnahmen bei zu hoher Reduktionsstärke geringfügige Artefakte erzeugen. Der Benutzermodus ermöglicht es, die Intensität zu reduzieren, um die ursprüngliche Stimmklangcharakteristik zu erhalten.
Fazit & Handlungsaufforderung
Adobe Speech Enhancer füllt eine kritische Lücke im Audio-Produktionsprozess, indem er schnelle, KI-gesteuerte Reinigung liefert, die viele Desktop-Lösungen erreicht, ohne komplexe Software-Installationen zu erfordern. Für Kreative, die regelmäßig Podcasts, Webinare, Online-Kurse oder Sprecherstimmen veröffentlichen, kann die gesparte Post-Production-Zeit in Inhaltsproduktion, Zuschauerbindung oder sogar die Erschließung neuer Formate investiert werden. Obwohl er die volle Funktionalität einer professionellen DAW nicht ersetzt, überzeugt er als Erstbearbeitung, die Klarheit drastisch verbessert, Hintergrundrauschen reduziert und eine konsistente Lautstärke über alle Episoden hinweg sicherstellt. Das Abonnementmodell, kombiniert mit kontinuierlichen KI-Updates und robusten Sicherheitsmaßnahmen, macht ihn zu einer zukunftssicheren Investition für Einzelpersonen und Unternehmen gleichermaßen.
Bereit, Ihrer Stimme ein professionelles Finish zu geben? Adobe Speech Enhancer jetzt herunterladen, die kostenlose Testversion starten und die Bequemlichkeit der KI-gesteuerten Cloud-Audio-Verbesserung erleben. Heben Sie Ihre Aufnahmen auf ein neues Level, halten Sie Ihre Zuhörer fasziniert und lassen Sie Ihr Content so überzeugend klingen, wie er aussieht.